


 Wybrane elementy graficzne tej sekcji powstały przy wsparciu AI
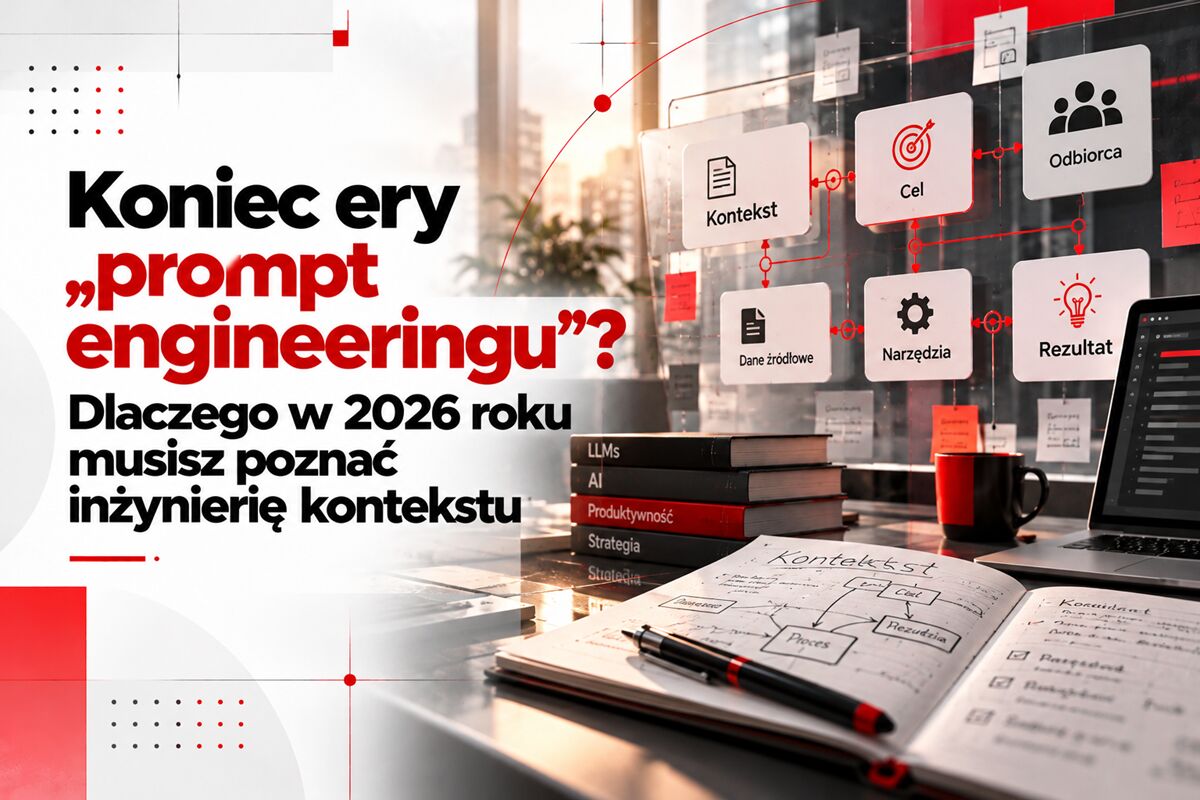
Koniec ery „prompt engineeringu”? Dlaczego w 2026 roku musisz poznać inżynierię kontekstu
Spis treści
Pamiętacie te wszystkie „magiczne zaklęcia”, PDF-y z zestawami stu idealnych promptów na każdą okazję i poradniki w stylu: „Napisz: działaj jak programista z dwudziestoletnim stażem, a model da ci bezbłędny kod”? No cóż, szczerze mówiąc, obecnie nie ma to raczej większego sensu.
Kiedy człowiek siada do napisania prostego skryptu albo chce wygenerować post na media społecznościowe, taki prompt może jeszcze wystarczyć. Schody zaczynają się w momencie, gdy zamykamy okno przeglądarki i wchodzimy do terminala. Prawdziwe repozytorium, tysiące linii kodu, zależności, zmieniający się stan aplikacji i agent autonomiczny, który ma coś faktycznie zaimplementować, a nie tylko o tym pogadać. Nagle te wszystkie wycyzelowane formułki biorą w łeb.
Dlaczego? Odpowiedź, pojawia się w nowej książki Edena Marco „Claude Code i programowanie agentowe” i jest rozbrajająco prosta: prompty są z natury statyczne, podczas gdy praca z kodem jest potwornie dynamiczna.
I właśnie w tej szczelinie rodzi się inżynieria kontekstu.
Mityczny „wrapper” i środowisko uruchomieniowe agenta
Często słyszy się w kuluarach - czasem z lekkim przekąsem - że współczesne narzędzia programistyczne oparte na AI, jak choćby Claude Code czy Cursor, to w gruncie rzeczy „zwykłe nakładki na LLM-y”. Ale autor zwraca uwagę na coś kluczowego: choć jest w tym stwierdzeniu ziarno prawdy, to cała prawdziwa inżynieria leży dziś nie w samym odpytywaniu modelu, lecz w tym, co go otacza.
W branży mówi się na to agent harness - środowisko uruchomieniowe lub warstwa orkiestracji.
Wywołanie samego modelu to w zasadzie prosta sprawa. Prawdziwa sztuka polega na kontrolowaniu pętli agenta, obsłudze błędów, wywoływaniu narzędzi i - przede wszystkim -decydowaniu w ułamku sekundy, jaki wycinek rzeczywistości w ogóle wysłać do modelu w danym kroku. Bo model nie czyta w myślach i nie widzi całego Twojego dysku na raz. Widzi tylko to, co upchniemy w jego oknie kontekstowym.
I tu dochodzimy do odwiecznej zasady informatyki: garbage in, garbage out. Jeśli wpuścisz do okna śmieci, dostaniesz z powrotem halucynacje i popsuty build.
Anatomia katastrofy: jak psuje się okno kontekstowe
Kiedy agent zaczyna działać w pętli (odpala testy, czyta pliki, wykonuje polecenia powłoki), do okna kontekstowego napływają kolejne informacje zwrotne. Z rundy na rundę kontekst puchnie. Koszty rosną, czas oczekiwania na odpowiedź zaczyna irytować, a model… no właśnie, model zaczyna po prostu głupieć.
W książce świetnie zdefiniowano trzy zjawiska, które w praktyce potrafią położyć nawet najbardziej obiecujący proces:
- Zatrucie kontekstu (context poisoning) - wystarczy, że model w trzecim kroku zmyśli jakąś funkcję albo narzędzie zwróci błędny wynik; jeśli ta halucynacja zostanie w historii, model zacznie traktować ją jak fakt i oprze na niej całą dalszą pracę.
- Dezorientacja kontekstowa (context distraction) - do okna trafiają megabajty logów czy definicje niepotrzebnych narzędzi; model niby zna odpowiedź, ale „gubi igłę w stogu siana”, bo rozpraszają go nieistotne detale.
- Konflikt kontekstu (context clash) - moment, w którym instrukcje z różnych źródeł zaczynają sobie wzajemnie przeczyć i agent kręci się w kółko.
Wydaje się więc - i to chyba najważniejsza lekcja - że sztuka programowania agentowego wcale nie polega na ładowaniu wszystkiego do pamięci, tylko na bezwzględnej dyscyplinie selekcji.
Cztery strategie: jak robi to Claude Code?
No dobrze, ponarzekaliśmy na ograniczenia okna, ale jak sobie z tym radzić w realnym projekcie? Eden Marco, analizując architekturę Claude Code, wyodrębnia cztery konkretne filary inżynierii kontekstu:
- Pamięć trwała i hierarchia plików
Zamiast za każdym razem tłumaczyć modelowi architekturę aplikacji, konfigurujemy pliki pamięci, z CLAUDE.md na czele. Piękne jest to, że taki plik ląduje w repozytorium i podlega kontroli wersji, więc cały zespół współdzieli ten sam kontekst. Mało tego, w Claude Code można dynamicznie importować pamięć składnią @sciezka/do/pliku.md.
Można nawet napisać prosty skrypt powłoki podpięty pod hook, który w zależności od gałęzi Gita podrzuca modelowi tylko to, co ważne - np. kontekst bazy danych, gdy pracujemy nad migracjami. (Nawiasem mówiąc, Marco słusznie przestrzega w książce przed bezmyślnym dopisywaniem ścieżek przez >> - bez sprawdzenia grep -qxF plik szybko zmieni się w bezużyteczny śmietnik powtórzeń).
- Inteligentne, dynamiczne pobieranie
Zamiast ładować cały projekt, model sam przeszukuje hierarchię katalogów w poszukiwaniu odpowiednich plików. Jeśli pracujesz w głębokim podfolderze, Claude Code potrafi pobrać kontekst z katalogów nadrzędnych, priorytetyzując informacje najbardziej szczegółowe i najświeższe. Można też w locie dodać trwałą regułę poleceniem /memory add.
- Kompresja: higiena terminala
Narzędzie daje nam dwa wbudowane zawory bezpieczeństwa:
/clear - kiedy czujesz, że dyskusja zabrnęła w kozi róg; czyści historię rozmowy, ale nie rusza pamięci projektu. Taki twardy reset bez utraty tożsamości.
/compact - podsumowuje dotychczasowy dialog, wycinając gadulstwo, a zachowując kluczowe decyzje architektoniczne. Mniej tokenów, niższe rachunki, świeża przestrzeń na nowe wnioskowanie.
- Izolowanie kontekstu za pomocą subagentów
Zamiast zmuszać jednego agenta do bycia omnibusem - co zazwyczaj kończy się chaosem - powołujemy wyspecjalizowane subagenty. Subagent dostaje od głównego agenta tylko jedno, konkretne zadanie w postaci wygenerowanego promptu. Działa we własnym, odizolowanym oknie kontekstowym, robi swoje (np. przegląda pull request pod kątem bezpieczeństwa albo bada zewnętrzną bibliotekę) i zwraca do głównego wątku wyłącznie skondensowany wynik. Główny kontekst pozostaje czysty, a trudna robota została wykonana.
A co z promptem systemowym? Zasada „Złotowłosej”
Czy to wszystko oznacza, że inżynieria promptów całkowicie umarła? Nie do końca. Prompty systemowe wciąż stanowią szkielet poznawczy modelu. Tyle że zmieniło się podejście do ich pisania.
Marco przywołuje koncepcję, którą inżynierowie Anthropic określają mianem ekosfery (albo strefy Goldilocks - jak w bajce o Złotowłosej i trzech niedźwiadkach: nie za gorąca, nie za zimna, lecz w sam raz).
- Jeśli stworzysz prompt zbyt szczegółowy, traktujesz model LLM jak prymitywną, deterministyczną maszynę stanów. Wypisujesz sztywne instrukcje typu: „zawsze zadaj dokładnie trzy pytania”, próbujesz przewidzieć każdy możliwy warunek brzegowy. Efekt? Koszmar w utrzymaniu, a gdy tylko pojawi się nietypowa sytuacja, model natychmiast się wykłada.
- Z kolei prompt zbyt ogólny („bądź pomocnym asystentem i działaj zgodnie z duchem firmy”) zakłada, że model ma wiedzę domyślną, której w rzeczywistości nie posiada. Kończy się to losowością i brakiem spójności.
Dobry prompt systemowy leży dokładnie pośrodku: wyznacza wyraźne granice (kim agent jest, a kim nie jest), daje ramę rozumowania zamiast sztywnego algorytmu i uczy zasad oraz heurystyk, pozostawiając modelowi elastyczność w doborze konkretnych narzędzi.
Kilka luźnych myśli na koniec
Zastanawiamy się czasem, jak szybko to wszystko pędzi. Jeszcze niedawno ekscytowaliśmy się tym, że chatbot potrafi napisać prostą funkcję odwracającą stringa. Dziś rozmawiamy o wieloagentowych systemach operujących bezpośrednio w drzewie plików i zarządzających własną pamięcią roboczą.
Jeśli mielibyśmy wyciągnąć jedną praktyczną lekcję z rozdziału Edena Marco, brzmiałaby ona tak: przestań obsesyjnie szlifować pojedyncze zdania w zapytaniu do modelu, a zacznij myśleć jak architekt danych wejściowych. Kontroluj to, co wpada do okna kontekstowego, tnij zbędny szum i pozwól agentom pracować w czystym środowisku. Bo w 2026 roku przewagę zyskują nie ci, którzy potrafią ładnie poprosić sztuczną inteligencję o pomoc, ale ci, którzy potrafią stworzyć dla niej bezbłędny ekosystem do działania.
Zobacz nasze propozycje
-
-
książka
-
ebook
(53,40 zł najniższa cena z 30 dni)
54.29 zł
89.00 zł (-39%) -
-
-
książka
-
ebook
(77,40 zł najniższa cena z 30 dni)
78.69 zł
129.00 zł (-39%) -
-
-
książka
-
ebook
(49,50 zł najniższa cena z 30 dni)
60.39 zł
99.00 zł (-39%) -
-
-
książka
-
ebook
(53,40 zł najniższa cena z 30 dni)
54.29 zł
89.00 zł (-39%) -
-
-
książka
-
ebook
(53,40 zł najniższa cena z 30 dni)
54.29 zł
89.00 zł (-39%) -
-
-
książka
-
ebook
Czasowo niedostępna
-
-
-
książka
-
ebook
(53,40 zł najniższa cena z 30 dni)
54.29 zł
89.00 zł (-39%) -
-
-
książka
-
ebook
(71,40 zł najniższa cena z 30 dni)
72.59 zł
119.00 zł (-39%) -
-
-
książka
-
ebook
(41,40 zł najniższa cena z 30 dni)
42.09 zł
69.00 zł (-39%) -