

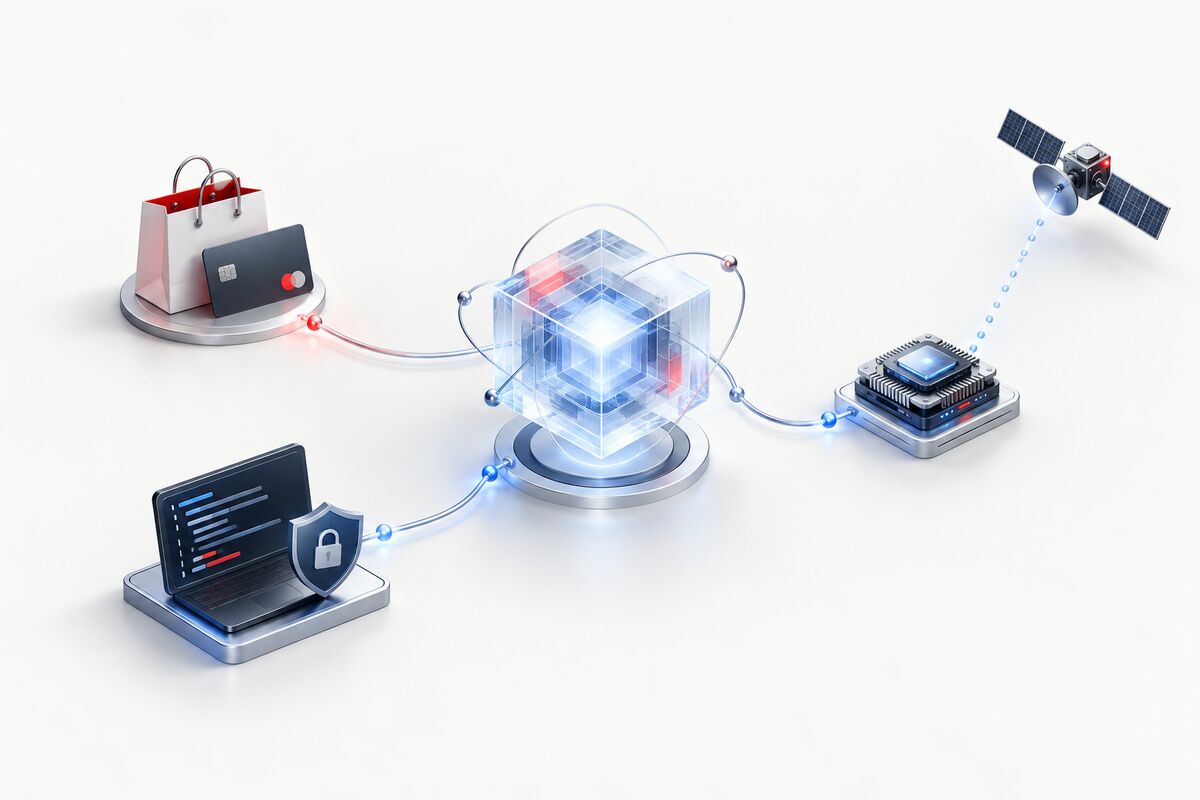

 Wybrane elementy graficzne tej sekcji powstały przy wsparciu AI
Newsy IT: Agent już nie tylko podpowiada. Kupuje, naprawia kod i prosi o dostęp
Spis treści
Ostatnio zastanawialiśmy się: „czy AI napisze za mnie tekst albo funkcję?”. Teraz pytanie trochę się przesuwa. Czy agent może zrobić zakupy, wynegocjować warunki, poprawić lukę w repozytorium, a potem - przy okazji - poprosić o token albo zmianę webhooka?
Technicznie: coraz częściej tak. Organizacyjnie: no właśnie, tu zaczyna się ciekawsza część.
Miniony tydzień nie przyniósł jednego modelu, który rzekomo zmienia wszystko. I dobrze. Przyniósł za to kilka mniej widowiskowych, ale bardziej konsekwencyjnych sygnałów. Agenci AI zaczynają wykonywać zadania mające skutek finansowy lub techniczny, firmy próbują mierzyć ich wpływ, a systemy bezpieczeństwa coraz wyraźniej mówią: przed naprawdę ważnym ruchem pokaż, że za sterami wciąż siedzi człowiek.
Najważniejsze informacje
-
Agenci AI coraz częściej przechodzą od podpowiadania do wykonywania realnych działań - mogą negocjować, kupować, zmieniać kod i korzystać z uprawnień użytkownika.
-
Wraz z większą autonomią rośnie znaczenie odpowiedzialności i kontroli - firmy muszą wiedzieć, kto uruchomił zadanie, jakie działania wykonał agent i na jakiej podstawie.
-
AI w developmentcie powinno być mierzone nie tylko liczbą wygenerowanych zmian, ale także wpływem na cały proces: review, kolejki, czas oczekiwania i jakość poprawek.
-
Bezpieczeństwo coraz częściej opiera się na dobrych ustawieniach domyślnych i dodatkowym potwierdzaniu operacji wysokiego ryzyka, np. przez ponowne logowanie lub MFA.
-
Obliczenia AI nie muszą odbywać się wyłącznie w chmurze - rośnie znaczenie lokalnego AI i edge computingu, szczególnie tam, gdzie liczą się koszty, prywatność, opóźnienia lub ogromne zbiory danych.
-
Najważniejszym pytaniem przestaje być „który model jest najlepszy?”. Coraz ważniejsze jest to, co agent może zrobić, jakie ma uprawnienia, gdzie działa i kto odpowiada za skutki jego decyzji.
Agent idzie na zakupy
Anthropic przeprowadził Project Swap, czyli kontrolowany rynek wymiany książek. Agenci zbierali informacje o gustach uczestników, tworzyli rankingi i negocjowali między sobą. To brzmi trochę jak akademicka zabawa - książka za książkę, nic dramatycznego - ale mechanika jest bardzo podobna do przyszłego handlu agentowego. Trzeba poznać preferencje, znaleźć ofertę, podjąć decyzję i zawrzeć transakcję.
W eksperymencie dało się też zobaczyć coś mniej efektownego: jakość wyniku zależała nie tylko od sprytu podczas negocjacji, ale od tego, jak dobrze agent zrozumiał człowieka. Brak informacji o preferencjach bywał ważniejszy niż chytry prompt. To cenna obserwacja dla e-commerce. Jeśli agent ma kupować w naszym imieniu, karta produktu musi być jednoznaczna, warunki zwrotu czytelne, a ograniczenia produktu - dostępne maszynowo. SEO dla ludzi nie znika, lecz obok wyrasta coś w rodzaju „agent experience”. Nazwa może się jeszcze nie przyjąć, ale problem już jest.
Zresztą nie tylko laboratoria widzą ruch. John Lewis podał, że udział wyszukiwań pochodzących od agentów AI wzrósł w ciągu roku z 0,3 do 2,5 procent. To nadal mało. Osiem razy więcej też jednak nie jest drobiazgiem.
Banki studzą entuzjazm. NatWest, Bank of America, ING, Capital One i inne instytucje ostrzegają, że agent może wybrać słabiej chronioną metodę płatności, przekazać dane karty nie temu podmiotowi albo skierować klienta do oferty, której motywacji nie rozumiemy. Szczerze mówiąc, to właśnie tu kończy się niewinna rozmowa o wygodzie. Zaczynają się chargebacki, spory, prywatność i pytanie: czy agent reprezentuje użytkownika, sklep, czy może sponsora rekomendacji?
„To agent zrobił” raczej nie wystarczy
W tym samym tygodniu przewodniczący amerykańskiej FTC Andrew Ferguson powiedział wprost, że nie chce traktować agentów jak istot z własną wolą. Jeśli ktoś instruuje narzędzie, a narzędzie wykonuje instrukcję, odpowiedzialności należy szukać po stronie twórcy lub operatora. Istniejące przepisy nadal mogą działać, również te dotyczące naruszeń danych.
Można się zastanawiać, jak dokładnie sądy i regulatorzy przełożą tę wypowiedź na praktykę. To dopiero stanowisko, nie gotowy kodeks dla agentów. Kierunek jest jednak klarowny: antropomorfizowanie systemu nie zwalnia firmy z prowadzenia logów, ograniczania uprawnień ani kontroli tego, kto uruchomił zadanie. Agent nie stanie się magicznym buforem odpowiedzialności. Raczej nowym elementem łańcucha dowodowego.
I tu robię mały skręt, z zakupów do repozytoriów. W gruncie rzeczy problem jest ten sam.
Copilot zapamiętuje poprawki, organizacja liczy kolejki
GitHub połączył agentic autofix z Copilot Memory. Narzędzie może sięgnąć po wcześniejszy kontekst podczas poprawiania alertu bezpieczeństwa, a następnie zapisać wzorzec rozwiązania dla przyszłych zadań i innych funkcji Copilota. Repozytorium zaczyna mieć coś w rodzaju lokalnej pamięci praktyk bezpieczeństwa.
Brzmi obiecująco, choć funkcja jest nadal w public preview. Pamięć może utrwalać dobre wzorce, ale błędny wzorzec również jest wzorcem - ot, mało romantyczna prawda o automatyzacji. Dlatego równie interesująca jest druga zmiana: API metryk GitHuba rozkłada czas przeglądu pull requestu na oczekiwanie na pierwszą recenzję, drogę od pierwszej do ostatniej recenzji oraz czas od akceptacji do scalenia. Pokazuje medianę i 90. percentyl.
To nie jest detal dla wielbicieli dashboardów. Dzięki temu zespół może sprawdzić, czy AI rzeczywiście usuwa wąskie gardło, czy tylko produkuje więcej kodu czekającego w kolejce. Na razie metryki tych etapów liczą przeglądy z udziałem ludzi, nie botów. Paradoksalnie to dobrze pokazuje stan przejściowy: automatyzujemy, lecz nadal próbujemy zrozumieć ludzki kawałek procesu.
Dobry default jest ważniejszy niż kolejna prezentacja o governance
Równolegle GitHub dołożył walidator ustawień zarządzanych Copilota. Wyłapuje błędny JSON, złe mapowania zespołów i konfiguracje, przez które polityka może nie zostać zastosowana. Zapowiedział też globalną zasadę dla nowych funkcji. Od 22 października ogólnie dostępne możliwości pozostawione jako „nieustawione” odziedziczą firmowy default: włączone, wyłączone albo oddane do decyzji organizacji.
Ta zmiana jest mało instagramowa. Jest też, moim zdaniem, jedną z ważniejszych w całym tygodniu. Governance przestaje być slajdem z trzema kolorami ryzyka. Staje się plikiem konfiguracyjnym, domyślną wartością, recenzją zmiany i pytaniem, kto ma prawo wykonać commit. Czyli - trochę przewrotnie - wracamy do rzemiosła DevOps.
Bezpieczny default bywa bardziej skuteczny niż piękna polityka, której nikt nie potrafi przełożyć na ustawienia.
Czasem system powinien powiedzieć: pokaż się jeszcze raz
Kolejna nowość GitHuba nosi nazwę proof of presence. Przed operacją wysokiego ryzyka, na przykład utworzeniem tokenu, zmianą webhooka albo ustawień bezpieczeństwa, administrator może wymagać świeżego logowania, MFA lub potwierdzenia zgodności urządzenia u dostawcy tożsamości. Na razie mechanizm działa w ograniczonym public preview dla firm korzystających z zarządzanych kont i Microsoft Entra ID.
Tu warto nie przeceniać dostępności, lecz docenić zasadę. Ważna operacja nie powinna przejść tylko dlatego, że ktoś - albo jakiś proces - ma nadal ważne cookie. W świecie agentów sesja użytkownika może otwierać drogę do działania, którego użytkownik w danej chwili wcale nie zamierzał wykonać. „Świeża obecność” człowieka staje się więc osobną kontrolą bezpieczeństwa. Trochę tarcia wraca celowo. I chyba słusznie.
AI schodzi z chmury. A czasem odlatuje na orbitę
Drugi nurt tygodnia dotyczy miejsca wykonywania obliczeń. Apple pokazuje nowe Mac mini i Mac Studio jako lokalną alternatywę dla części kosztów tokenowych w chmurze. Cztery połączone komputery Mac Studio uruchamiały w demonstracji model o bilionie parametrów, który szukał i poprawiał błąd w kodzie graficznym. Całość miała działać z jednego gniazdka.
Nie znaczy to, że centrum danych można jutro zastąpić stosem komputerów pod biurkiem. Sprzęt kosztuje nawet blisko 20 tysięcy dolarów, a Apple ma niewielki udział w rynku firmowych desktopów. Jednak rozmowa o lokalnym AI staje się poważniejsza: gdzie są dane, ile kosztuje stałe użycie API, jakie opóźnienie jest akceptowalne i kto utrzyma cały ten majdan?
A na drugim końcu skali mamy orbitę. Google rozpoczyna test TPU w ramach Project Suncatcher, badając promieniowanie, chłodzenie i łączność laserową. To przedsięwzięcie długoterminowe, nie oferta na przyszły kwartał. Bardziej konkretny jest satelita MOI-1A firmy TakeMe2Space z układem Nvidia Orin NX. Klienci mają wysyłać na niego kontenery z modelami, przetwarzać obrazy na orbicie i sprowadzać na Ziemię analizę zamiast wielkiej paczki surowych danych.
Kosmos jest tu chwytliwym obrazkiem, ale sedno bywa prozaiczne: nie przenoś terabajtów, jeśli możesz przenieść kilkadziesiąt megabajtów kodu. Ten sam rachunek dotyczy fabryki, kamery, samochodu czy urządzenia IoT. Edge computing po prostu dostał bardzo wysoko położony przypadek użycia.
Najważniejsza zmiana nie dotyczy jednego modelu
Po tym tygodniu wyłania się dość spójny obraz. AI przesuwa się od odpowiedzi do czynności. Czynność potrzebuje uprawnienia. Uprawnienie potrzebuje reguły, świeżego potwierdzenia i śladu audytowego. A obliczenie wcale nie musi odbyć się w największej możliwej chmurze - może być przy repozytorium, obok danych, na biurku, a czasem kilkaset kilometrów nad nami.
Może więc nie warto pytać wyłącznie, który model jest najlepszy. Lepszy zestaw pytań brzmi: co agent może zrobić, skąd wie, czego chcemy, gdzie działa, kto widzi jego decyzje i kto zapłaci, gdy pójdzie nie tak. Mniej fajerwerków, więcej architektury. Dla ludzi IT to akurat całkiem dobra wiadomość.
Źródła
- Anthropic: Project Swap — What happens when agents trade for us?, 24.09.2026
- Reuters: Banks warn AI shopping bots raise scam, fraud and data-privacy risks, 22.09.2026
- Reuters: FTC chair suggests AI developers should be liable for conduct of agents, 25.09.2026
- GitHub: Agentic autofix now uses Copilot Memory, 25.09.2026
- GitHub: Usage metrics API adds pull request review stages, 25.09.2026
- GitHub: Enterprise managed settings in-product validator, 25.09.2026
- GitHub: Default Enablement of Copilot features, 24.09.2026
- GitHub: Require proof of presence for high-impact actions, 24.09.2026
- Reuters: With new Macs, Apple aims to lower AI costs, 22–23.09.2026
- Google: Behind Project Suncatcher, 24.09.2026
- Reuters: TakeMe2Space to launch orbital computing satellite, 28.09.2026
Jeśli po tym przeglądzie chcesz zejść z poziomu trendów do konkretnych umiejętności — od agentów AI i bezpiecznego kodowania po edge computing — poniżej znajdziesz książki dobrane do tematów, które właśnie nabierają praktycznego znaczenia.
Zobacz nasze propozycje
-

-
książka
-
ebook
(54,29 zł najniższa cena z 30 dni)
55.18 zł
89.00 zł (-38%) -
-

-
książka
-
ebook
(53,40 zł najniższa cena z 30 dni)
55.18 zł
89.00 zł (-38%) -
-

-
książka
-
ebook
(77,40 zł najniższa cena z 30 dni)
79.98 zł
129.00 zł (-38%) -
-

-
książka
-
ebook
(77,40 zł najniższa cena z 30 dni)
79.98 zł
129.00 zł (-38%) -
-

-
książka
-
ebook
(53,40 zł najniższa cena z 30 dni)
55.18 zł
89.00 zł (-38%) -
-

-
książka
-
ebook
(49,50 zł najniższa cena z 30 dni)
61.38 zł
99.00 zł (-38%) -
-

-
książka
-
ebook
(71,40 zł najniższa cena z 30 dni)
73.78 zł
119.00 zł (-38%) -
-

-
książka
-
ebook
(41,40 zł najniższa cena z 30 dni)
42.78 zł
69.00 zł (-38%) -
-

-
książka
-
ebook
(41,40 zł najniższa cena z 30 dni)
42.78 zł
69.00 zł (-38%) -
-

-
książka
-
ebook
(89,40 zł najniższa cena z 30 dni)
92.38 zł
149.00 zł (-38%) -
-

-
książka
-
ebook
(40,20 zł najniższa cena z 30 dni)
41.54 zł
67.00 zł (-38%) -
-

-
książka
-
ebook
(35,94 zł najniższa cena z 30 dni)
37.14 zł
59.90 zł (-38%) -
-

-
książka
-
ebook
(47,40 zł najniższa cena z 30 dni)
47.40 zł
79.00 zł (-40%) -
-

-
książka
-
ebook
(77,40 zł najniższa cena z 30 dni)
77.40 zł
129.00 zł (-40%) -